Qwen4-Max深度评测:最新API价格、性能跑分与真实能力解析
阿里 2.4 万亿参数旗舰发布!单任务成本暴降60%,1M超长上下文站长实测,深度对比官方数据与真实代码能力:输出较快但前端翻车?一文看懂它到底值不值得用。
阿里通义千问Qwen4-Max已于2026年11月16日正式发布,此前进行了约一周的预览。
作为 Qwen4 系列的首款旗舰,官方给出的数据极其震撼:2.4万亿参数、1M上下文、Agent能力直逼海外巨头(我实测感觉约等于GPT-6.1-sol),且单任务成本暴降60%。
熟悉阿里模型的小伙伴可能都知道,通义千问以前的风格一直很“偏科”:开源的小模型(比如 7B、14B、27B)经常惊艳全场,但一到几百上千亿的大模型,在写代码和复杂逻辑推理上,总是感觉不尽人意。
所以,这次看到官方通稿把 Qwen4-Max 吹得这么神,我其实是持怀疑态度的。为了给大家最真实的选型参考,我赶紧从底层架构、API价格到真实代码生成,对它进行了一波深度实测。
一、 API 价格深度解析:这波确实“掀桌子”了
对咱们做开发、跑项目的朋友来说,模型智商再高,如果钱包顶不住那也是白搭。Qwen4-Max这次的定价策略,我只能用四个字形容:精准爆破。它直接砍在了中小团队和独立开发者最痛的成本大动脉上。
看看官方最新公布的价格表(国内站):
- 标准输入:¥10 / 百万 tokens
- 标准输出:¥30 / 百万 tokens
- 标称缓存命中:低至 ¥0.5 / 百万 tokens!
- 显式缓存创建:5 分钟 ¥12.5 / 1 小时 ¥20 / 百万 tokens。
我们来仔细算算实际情况: 可能有人觉得,单价看起来也没便宜到离谱?别急,官方在 Work360(覆盖 700 多个真实专业领域)的评测里给出了一个恐怖的数据:单任务的平均综合费用,从上一代的 ¥26.58 直接砸到了 ¥11.16,降幅高达 58%!
凭什么降这么多?答案藏在它的底层架构里:它变聪明了,也更抠门了。 官方数据显示,在处理同等复杂的 Terminal-Bench 任务时,Qwen4-Max 的 Token 消耗量比上一代锐减了约 48%。也就是说,以前它像个话唠,要啰嗦半天才切中要害;现在它学会了“精准思考”,只输出核心代码和逻辑。同样的活儿,它用的字数少了一半,你要付的钱自然也就暴跌了。
最后,那个标称 0.5 元/百万 token 的极限缓存价,参数确实很唬人。如果你能一直吃到这个满额缓存,那反复让它重构几万行的核心代码,成本简直跟白嫖一样。当然,官方给出的这仅仅是理论最低值,至于真实业务里到底能不能吃满缓存、命中率有多高……(这里我们先留个悬念,后面实测部分我会给大家说)。
单从这套价格组合拳来看,阿里这次确实是来掀桌子的。
二、 官方跑分与架构拆解:它到底凭什么拿第一?
看完价格,咱们回到最核心的问题:它变便宜了,那脑子到底有没有缩水?
咱们直接看官方放出的硬核数据。
1. 实战能力:拳打 GPT-6?且慢,Kimi 也是个狠角色
先看这张 16 项基准测试的对比图,蓝色是 Qwen4-Max。官方宣称它在多项指标上超越了 GPT-6 Astra 甚至 Claude Opus 5.5。
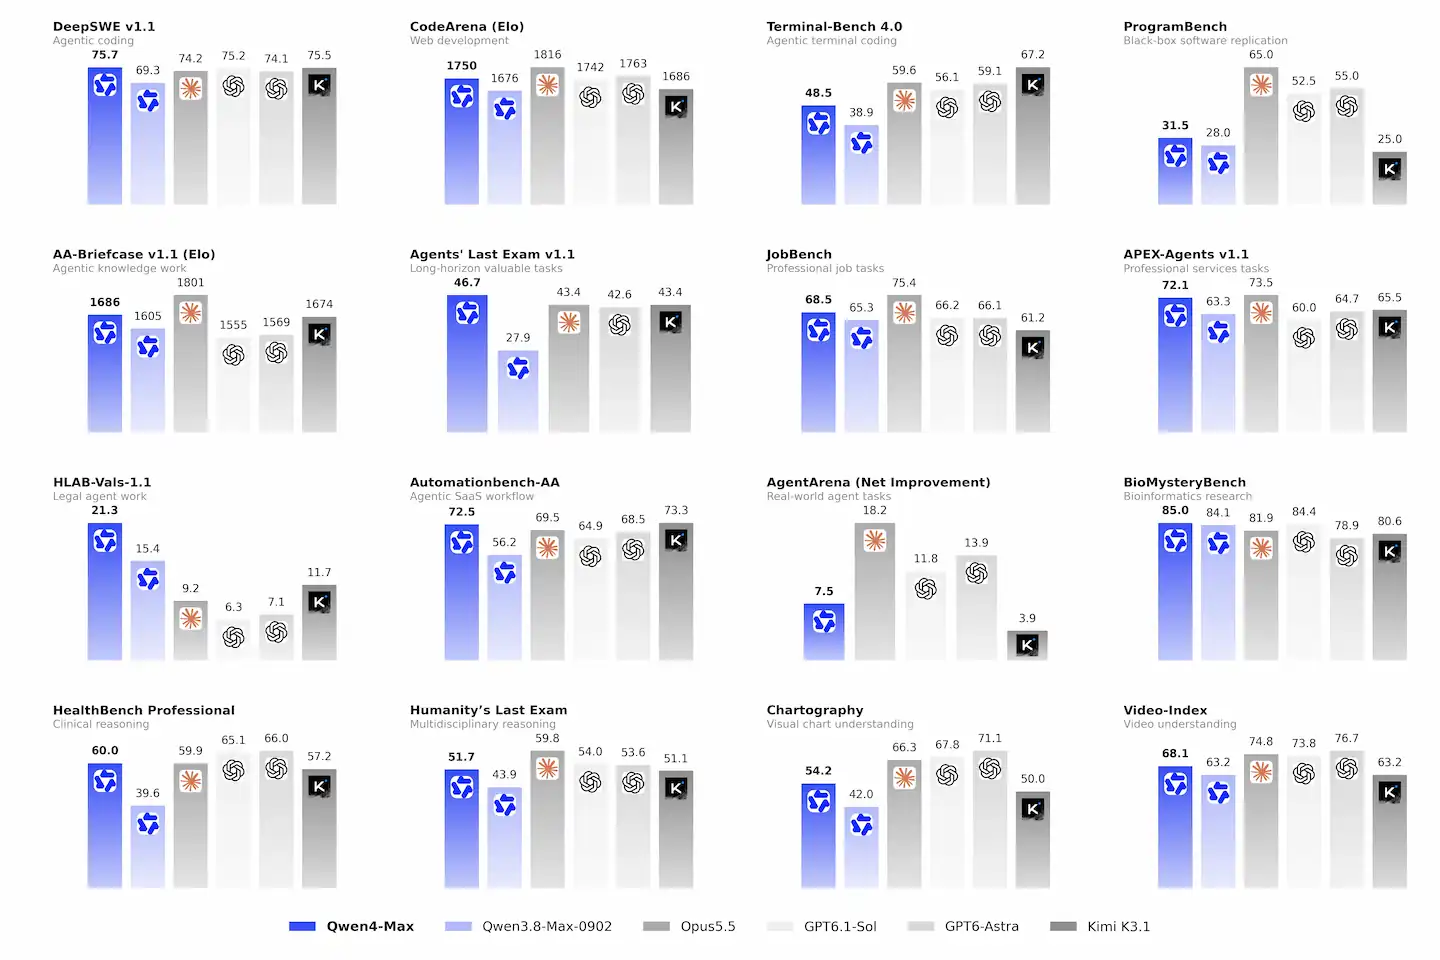
但大家仔细看图表底部的灰色和黑色柱子——Kimi K3.1 的表现极其抢眼。在 Web Dev(前端开发)上,Qwen4-Max 拿到了 1750 分,确实压了 GPT 一头;但在 Terminal-Bench 和部分 Agent 任务上,它和 Kimi 互有胜负。
这也就是我前面敢说“它实际体感只能排国产第二”的底气所在。官方数据很华丽,但真实业务场景里,Kimi 依然是极其强劲的对手。不过,在 DeepSWE(复杂代码)和生物医学等特定基准上,Qwen4-Max 确实展现出了断层式的领先。
2. 效率的魔法:高分,是用更少的 Token 换来的
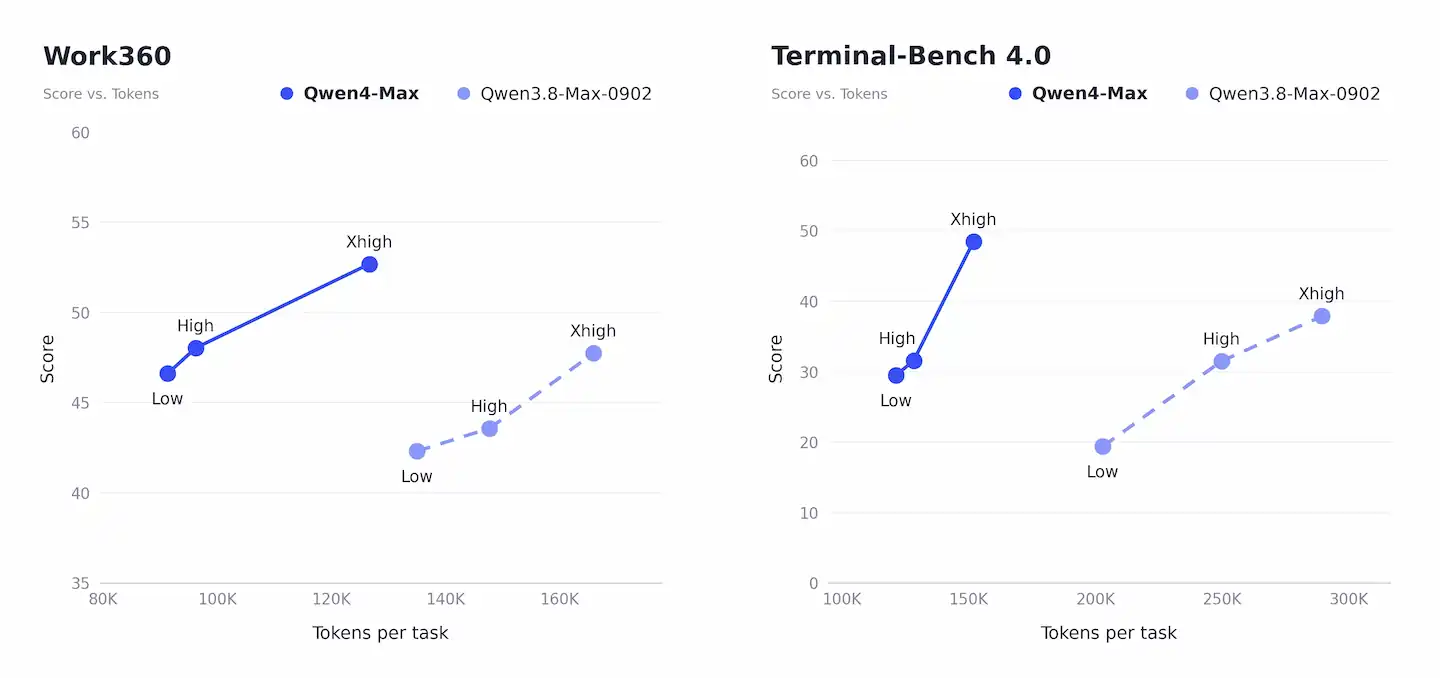
这张图是整个发布会最核心的机密。
横轴是“每个任务消耗的 Token 数”,纵轴是“得分”。你看代表 Qwen4-Max 的实心蓝点(Xhigh 档),它高高悬挂在左上角。这意味着什么?它不仅考了最高分,用的“字数”还最少。
对比那条虚线的 Qwen3.8-Max,上一代模型要达到 Qwen4 一半的分数,得消耗两倍以上的 Token。这就是为什么它 API 价格能降 60% 的根本原因:算法变聪明了,不废话了。
3. 底层手术:2.4万亿参数的暴力拆解
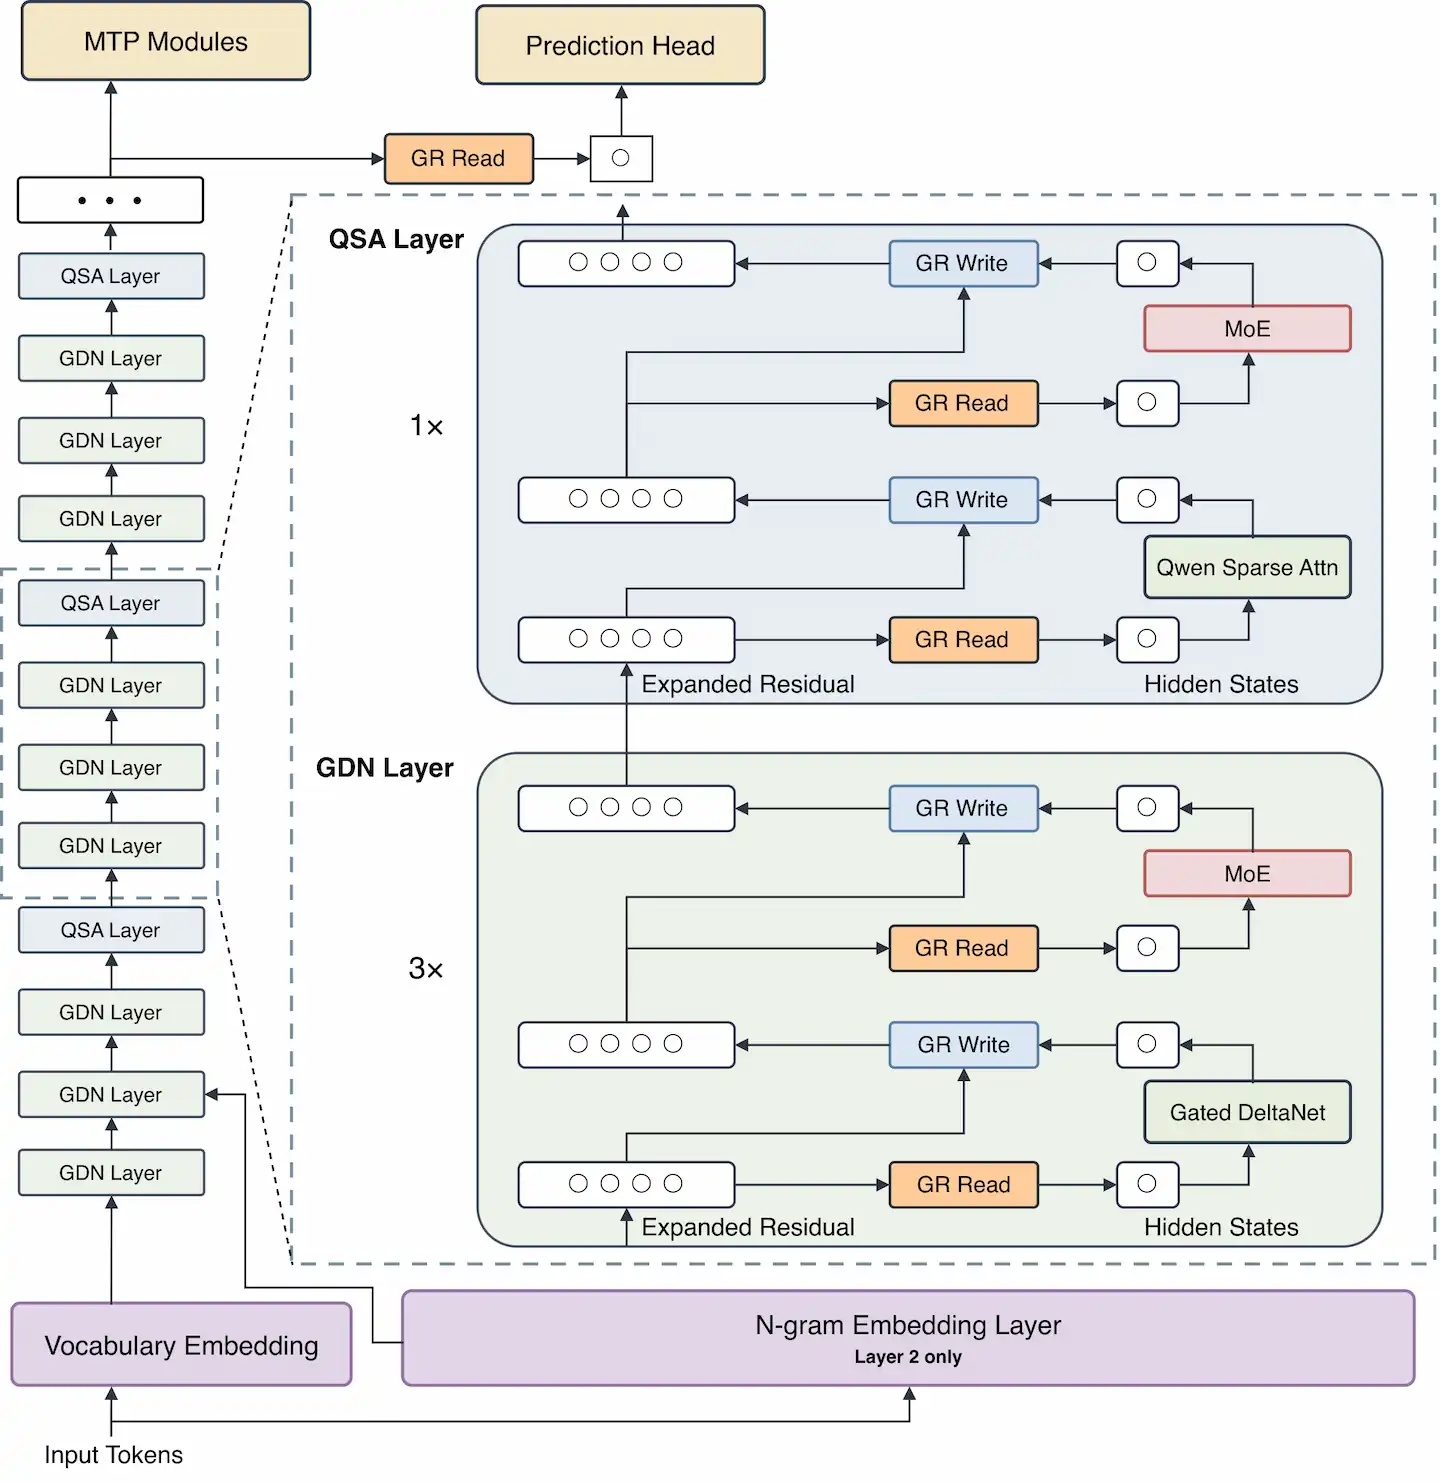
很多小白可能看不懂这张复杂的架构图,我用大白话翻译一下:
- 总参数 2.4T,每次只激活 71B:这就是它速度高达 100 tokens/s 的秘密。这就好比一个拥有 2.4 万亿神经元的大脑,每次思考只调动 71 亿个。保证智商的同时,功耗极低。
- Gated DeltaNet (GDN) 与 QSA 交替:你看图里每四层,有三层是绿色(GDN),一层是蓝色(QSA)。这种设计把历史信息压缩成固定状态,大幅降低了 1M 长上下文带来的算力爆炸。这就是为什么它敢让你塞几十万字进去。
4. 预训练的丝滑:没有“心梗”的 Loss 曲线
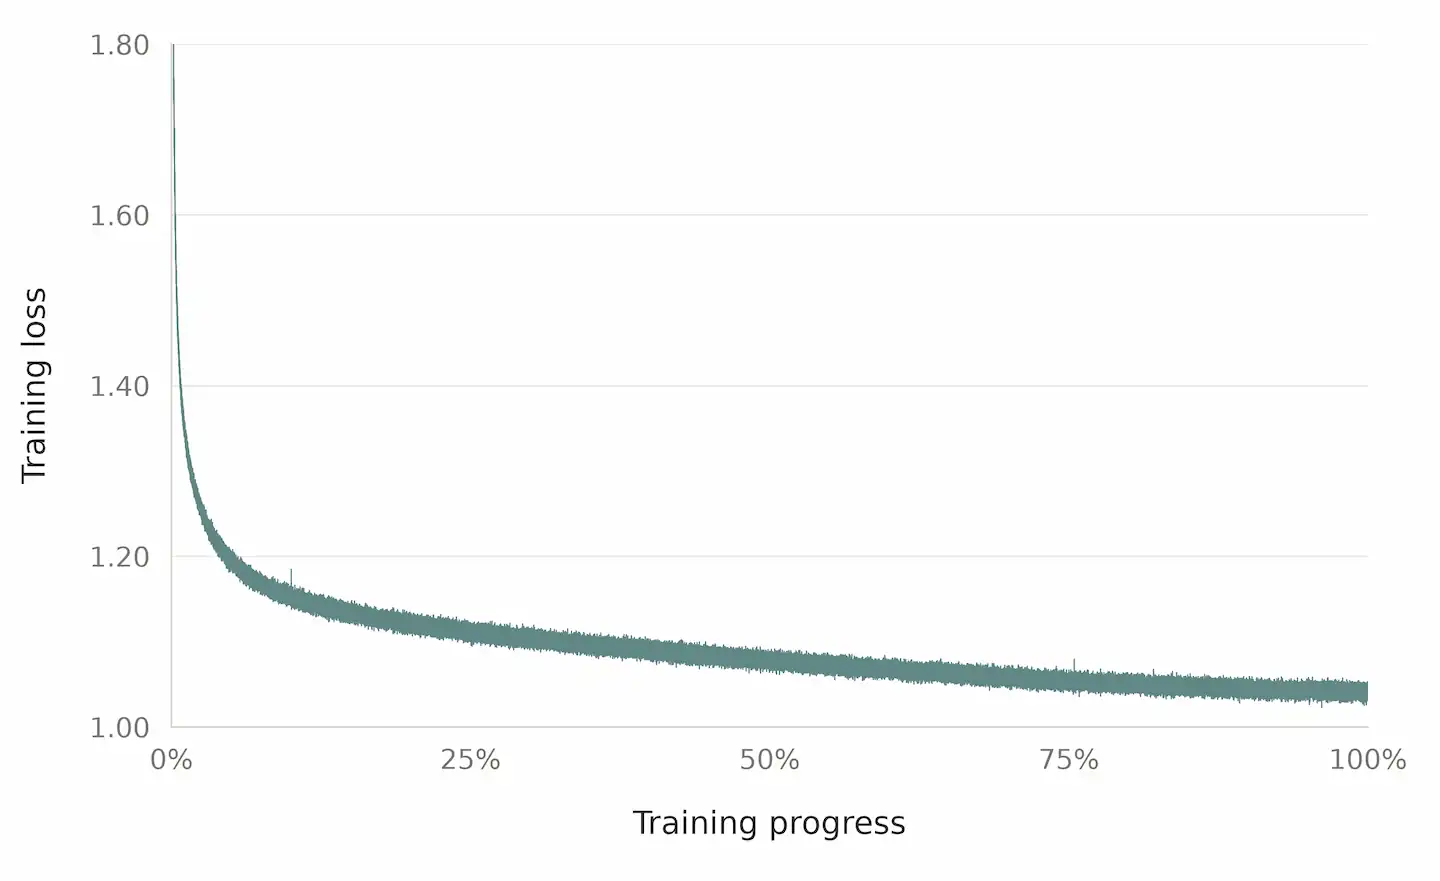
这张图给懂行的炼丹师看。预训练最怕的就是 loss spike(损失曲线突然飙升,意味着训练崩了)。Qwen4-Max 的曲线像德芙巧克力一样丝滑,一路平稳下降。这说明阿里的工程底座极其扎实,模型不会因为偶尔的上下文超长就突然胡言乱语。
总结一下纸面实力:从数据看,Qwen4-Max 绝对是一台兼顾了“高智商”与“低成本”的怪物。但跑分毕竟是死板的,真实业务里它会不会像某些模型一样“高分低能”?甚至暴露出什么致命短板?
让我们直接进实测环节~
三、 站长真实实测:速度惊人,但前端和缓存双双翻车?
官方通稿里的跑分确实华丽得让人流口水,但作为每天要在真实业务里“跑代码、洗数据”的老司机,咱们都知道一个铁律:跑分榜单上的神仙,在杂乱无章的实战环境里,往往要先打个八折。
为了看看它真实底细,我直接拉满 API 额度,用多个实际业务场景对它进行了压力测试。结论是:它的长板极长,但短板也足够让人头疼。
🌟 亮点 1:力大砖飞的吞吐速度(稳定 100 tokens/s)
这是整个实测环节最让我感到惊艳的地方。 得益于它单次仅激活 71B 参数的设计,以及底层的 N-gram 查表机制,它的 API 输出速度极其恐怖,全程稳定在 100 tokens/s 左右。对比我平时用的一些海外重型模型,速度翻了一倍不止。 跑复杂业务逻辑的补全时,几乎没有那种“光标闪烁等它思考”的停顿感,代码是“啪啪啪”连续跳出来的,体感极其丝滑。对于需要长文本输出的场景(比如批量生成 SEO 文章、翻译长文档),这个速度简直是效率神器。
🌟 亮点 2:垂直领域的“智商突变”
这次 Qwen4-Max 在专业领域的强化,绝不是吹出来的。 我尝试喂给它一段极其复杂的医疗病例(包含各项生化指标和既往病史),以及一份冗长的法律条款。它不仅能在 1M 的上下文中精准找到相关条款,还能给出逻辑极度严密的推理链条(比如指出某种药物与病史的潜在冲突)。 如果你在做金融研报分析、法律合同审查,或者医疗辅助问答,这个模型结合 1M 的上下文,绝对能帮你省下大量雇人看文档的钱。
🩸 痛点 1:前端能力尚可,但略逊 Kimi,且风格高度“撞车”?
官方在宣传里花了很大篇幅秀它的前端生成能力,甚至跑分直逼 Claude。但实测下来,它在写 React 和 Vue 时的表现,属于“能用”,但还没到“惊艳”的地步。
- 与 Kimi 高度同频:这是一个非常有意思的发现。我拿同一套前端组件测试 Qwen4-Max 和 Kimi K3.1 Pro,发现两者的代码风格、排版逻辑极其相似。Qwen4 的基础 UI 出图率很高,但一旦遇到复杂的嵌套交互、或者深层级的表格与弹窗,它的组件结构就容易出现细微错位。
- 略逊于 Kimi 的细腻度:综合来看,它的前端真实能力略微逊色于 Kimi K3.1 Pro。面对复杂的 React Hooks 或 Vuex/Pinia 状态联动,Qwen4 偶尔还会产生幻觉,写出需要你手动去排查的状态冲突。
- 建议:如果你是做简单的落地页或基础组件,它完全胜任;但如果是靠写重度前端吃饭的,目前 Kimi 或 Claude 依然是更丝滑的选择。
🩸 痛点 2:知识面“广而不深”,硬核能力距离顶尖尚有半步之遥
很多通稿说它的综合能力已经全面碾压海外巨头,但实测下来的真实体感是:它在特定领域的专精度,距离 Claude Opus 5.5 和 GPT-6.1 依然有一点点差距。
- 广度足够:它的知识面非常广,什么都懂一点,日常问答、写个脚本、做个中等难度的数据分析,它能给出逻辑非常严密的推理链条,特别是这次还特地训练了医疗、金融、法律等领域的知识,确实挺好用的。
- 深度欠缺:如果涉及到极度硬核的学术研究、复杂的底层算法推导,或者极高标准的后端架构设计,Qwen4-Max 给出的方案有时会显得“浅尝辄止”,不够一针见血。相比之下,顶尖海外模型在“深挖”这一块,底蕴还是更厚实一点。
- 总结:它非常适合做“全能型选手”或者“初稿生成器”,但如果是“攻坚”级的硬核任务,建议还是交叉验证一下。
🩸 痛点 3:令人心碎的缓存命中率(没想象中省钱)
第一章我们提到了它 0.5元/百万 token 的极低缓存价,很多极客看到这可能眼睛都亮了。但我要在这里泼一盆冷水:你大概率吃不到这么满的缓存。
实测下来,它的缓存命中率远远达不到 DeepSeek 那种 99% 的变态级别,甚至也达不到咱们站点 GPT 那种 95% 左右的普通水平。原因在于:
- 前缀极其敏感:你在对话中间稍微改了一个标点,或者插入了一段新的代码,后面整个庞大的上下文缓存可能就会全部失效。
- 格式要求苛刻:如果你的上下文格式不够规范,系统无法完全识别前缀树,缓存就建立不起来。 所以,如果你是频繁修改一句话去问它,你的实际扣费会比官方宣称的平均成本高出不少。 想靠它白嫖长文本,还得先学会怎么优雅地写 Prompt 前缀。
四、 开发者避坑指南:到底怎么用才能把钱花在刀刃上?
经过这一轮深度解析,结论其实已经很清晰了。Qwen4-Max 是一把极其锋利的双刃剑,用错了地方会伤到自己,用对了地方就是神器。如果你不想花冤枉钱,请严格按以下场景选型:
1. 别拿它当“前端画图仔”(慎用场景)
- 复杂 UI/UX 开发:放弃用它写高质量的前端组件。遇到复杂的交互逻辑、动画或者状态管理,老老实实切回 Claude 或者 Kimi。
- 小修改频繁的短任务:因为它的缓存命中率一般,如果你是那种“写两行、改一句、再问一下”的高频短交互,它的实际成本会变高,甚至不如用一些便宜的小模型划算。
2. 它是“长文档提取”与“后端脚本”的王者(强推场景)
- 复杂后端与数据处理:实测中,它写 Python 脚本、SQL 复杂查询以及后端 API 接口的能力极强,几乎一次成型,且少有 Bug。
- 超长文档精准分析:利用它 1M 的超长窗口,直接把一整套开源项目源码、几十份财报、数百页法律文书打包扔进去,让它做全局摘要和跨文档检索。只要你的文档结构清晰,它的逻辑推演能力会让你极其省心。
- 垂直行业 RAG(知识库):做医疗问答、金融风控系统,它的专业词汇理解和推理能力,在目前的国产模型中极其能打。
3. 如何极致榨干它的“缓存红利”?
如果你想吃到那 0.5 元/百万 token 的底价,提问方式必须大改:
- 不要分多次丢代码。把几千字的“不变代码架构”或者“政策文档”固定放在 Prompt 的最开头,作为永久前缀。
- 每次追问时,只在最末尾追加你的问题(如:“根据上述代码,帮我把数据库连接池改大一点”)。这样系统才能稳定命中前缀缓存,把你每次提问的成本打到最低。
总的来说: Qwen4-Max 不是来取代 Claude/GPT 的,它是来帮你降本增效的。把它当成一个“速度快、懂专业、支持超长文档的廉价后端外包”。不拿它做精雕细琢的前端活,用对地方,这套 2.4T 的架构绝对好用。
五、写在最后
在这个全网都在吹通稿的时代,做个真实跑数据的“老实人”不容易。我们不收厂家的钱,只把最真实的体验告诉大家。这篇文章的每一个数据,都是真金白银跑出来的。 如果你最近也在折腾国产大模型,或者有其他模型的排坑经历,欢迎在一起交流。后续有新的模型发布,我也会继续给大家探路!