GPT-6.2 Astra与Sol正式发布:最新API价格、性能跑分与深度测评
OpenAI 6.2 系列(Astra/Sol)深度评测。本文基于最新跑分与连夜重度实测,拆解 API 定价、后端逻辑、前端代码与响应速度的真实表现,帮开发者避开选型暗坑。
就在我写这篇文章的十几分钟前,OpenAI 于 2026 年 11 月 17 日 突然上线了 GPT-6.2 系列:旗舰级的 Astra 与走量级的 Sol。
这次发布其实早有端倪。发布前圈内传出微软 Azure 上托管的部分 英伟达集群疑似被攻破 ,让一部分人提前“内测”到了;同时,官方也确实进行了大约两周的灰度测试。距离初代 GPT-6 仅仅过去两个多月,节奏确实紧凑。
官方给这代的核心定调是「效率革命」:用更少的 Token 干更重的活。 但在连夜拉满额度、跑完几轮重度代码生成和逻辑推演后,我得出一个比较明确的结论:这是一次相当「偏科」的升级。它在后端逻辑和长程 Agent 上摸到了目前第一梯队的天花板,但在常规前端体验和响应速度上,短板依然明显。
以下基于官方一手数据与我的实机测试~
一、从定价逻辑看 OpenAI 的策略
我们先看最基础的商业底座。两款模型的价目表一出来,策略就很清晰了——这波操作本质上是一场精准的「价格压制」。
1. GPT-6.2 Astra(旗舰):单价不低,但总账单可能更低
对于旗舰模型,大家最关心的还是单价。相比上代,Astra 这次是「加量还降价」:
-
标准模式(Standard):
- 输入:$8.00 / 百万 Token
- 输出:$40.00 / 百万 Token
- 缓存命中:$0.40 / 百万 Token(降幅居然约 60%)
-
批量模式(Batch,50%折扣):输入 $4.00 / 输出 $20.00 / 缓存 $0.20
-
快速模式(Fast):输入 $16.00 / 输出 $80.00 / 缓存 $0.80
-
(注:Ultrafast 超快模式价格会随时间调整,在 2027 年 2 月 28 日前为标准费率的 3 倍,之后恢复 6 倍)
这套价格背后的逻辑: $40 的输出单价看起来不便宜,但官方强调 Astra 在复杂任务中,输出 Token 比前代减少了约 22%。在 Agents’ Last Exam 这类长程多步任务里,它的单任务总成本不到前代的 1/3。它不再像早期 GPT-6 那样啰嗦,而是更倾向于直接输出核心逻辑。用更少但更精的 Token,把总账单压了下来。
2. GPT-6.2 Sol(走量):教科书级的「以下犯上」
这是本次更新最狠的一刀。Sol 不仅维持了上代原价,在部分维度还直接逼近旗舰:
-
标准模式(Standard):
- 输入:$2.00 / 百万 Token
- 输出:$10.00 / 百万 Token
- 缓存命中:$0.10 / 百万 Token
-
批量模式(Batch,50%折扣):输入 $1.00 / 输出 $5.00 / 缓存 $0.05
-
快速模式(Fast):输入 $4.00 / 输出 $20.00 / 缓存 $0.20
技术视角的颠覆: 在 Cognition 的 FrontierCode 2.0(测试代码合并标准)中,Sol 距离旗舰 Astra 仅差 0.5 分,但成本只有 Astra 的五分之一。如果是日常写代码、做脚本,Sol 的性价比直接拉满。可以说,Sol 才是这波更新里真正用来走量的主力。
同样的活到底差多少钱?
如果你对抽象的数字没概念,我们直接拿一个 10 万 Token 上下文 + 2 万 Token 输出 的中等代码任务来估算(标准模式):
- 用 Astra:(0.1 × $8) + (0.02 × $40) = $1.60 / 次
- 用 Sol:(0.1 × $2) + (0.02 × $10) = $0.40 / 次
如果是重度开发者,一天跑 100 次:
- Astra 一天约 $160(约 1150 元人民币)
- Sol 一天约 $40(约 288 元人民币)
这就是为什么我说「Sol 才是普通人的真命天子」。一天省下近 900 块,而它只比 Astra 差了 0.5 分。
二、 官方跑分深度拆解:理智看待“SOTA”
不要被通稿完全带节奏~这代 6.2 系列跑分最大的看点,不是分数有多高,而是在相对低的成本下把分数拉到了第一梯队。
1. 长程 Agent 的绝对统治力:告别“走一半就迷路”
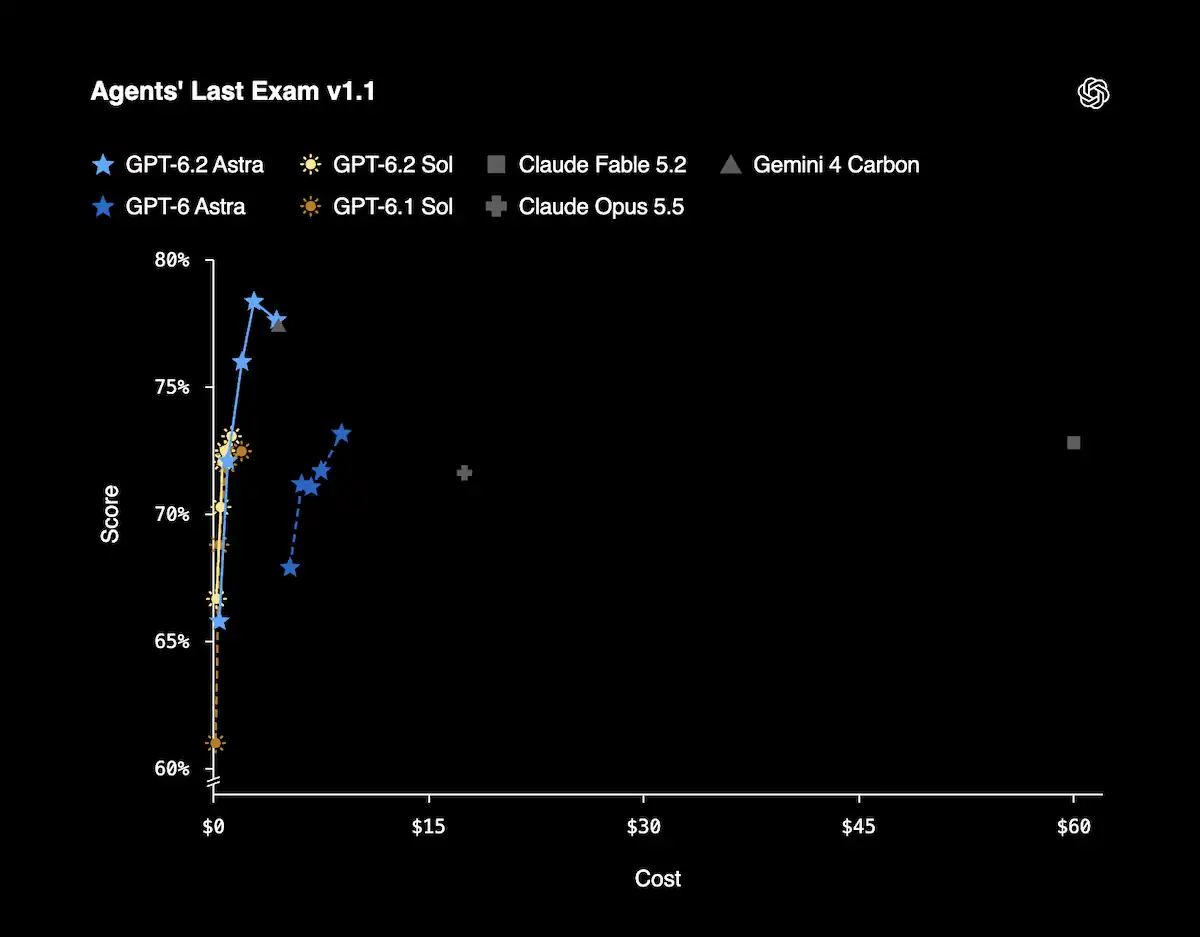
这是一张很残酷的「绞肉机」榜单。横轴是单任务成本,纵轴是得分。代表 Astra 的蓝色星标曲线,几乎以垂直姿态冲到了左上角(接近 80% 且成本极低)。
Agents' Last Exam 测的是什么?是模型在多步、长依赖链中的耐力。比如自动排查服务器集群故障、自主完成一个完整微服务架构的研发。过去的大模型(包括 Claude Opus 和早期的 GPT-6),在跑到第 10 步或第 20 步时,往往会因为上下文太杂而「忘记初心」,出现逻辑漂移或幻觉。
Astra 之所以能以明显的成本优势占据榜首,是因为它在底层做了更强的推理剪枝与记忆压缩。它能在长链条中更精准地保留核心目标,砍掉冗余思考。对于需要挂载大量外部工具的 Agent 开发者来说,这意味着更高的「任务一次通过率」。
2. 垂直行业的专业级降维:从“文科生”到“硬核专家”
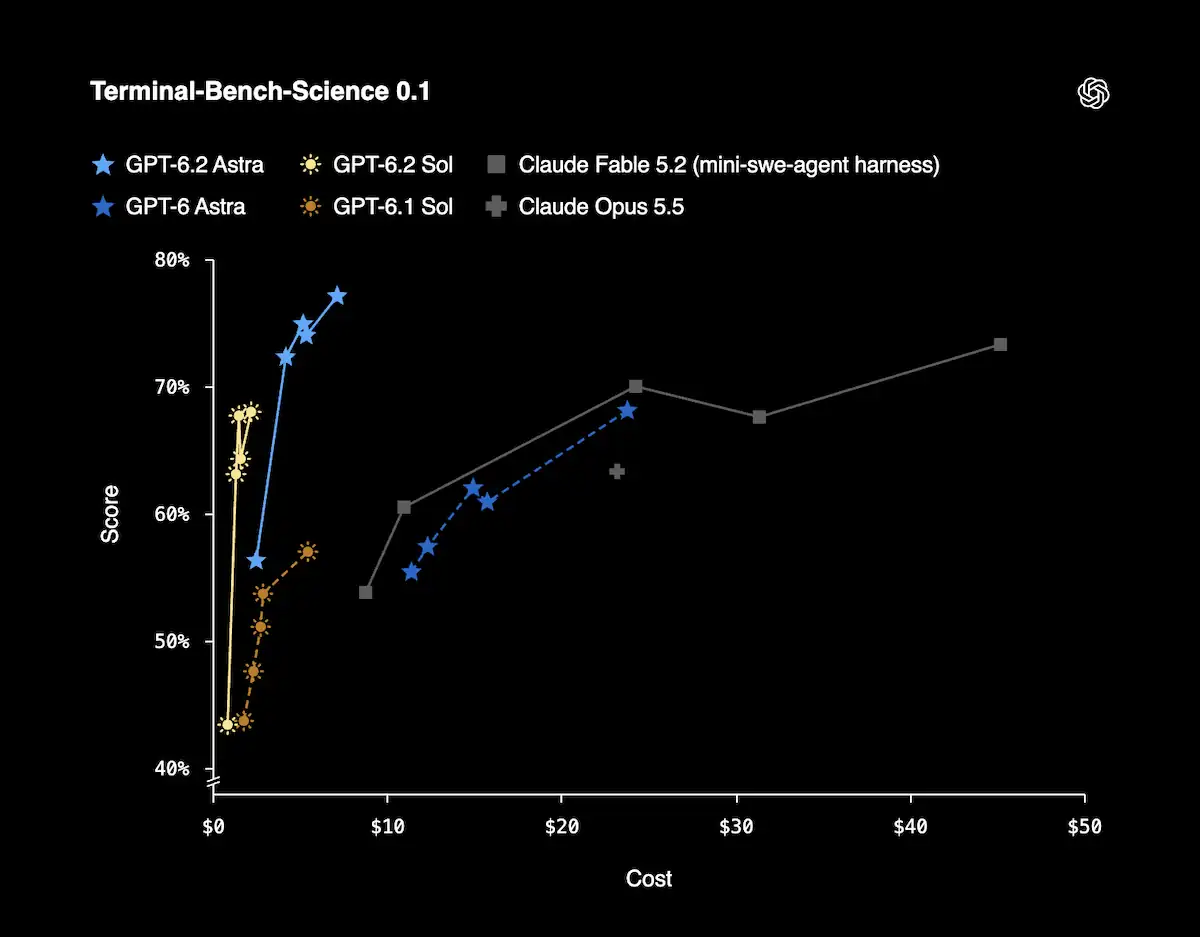
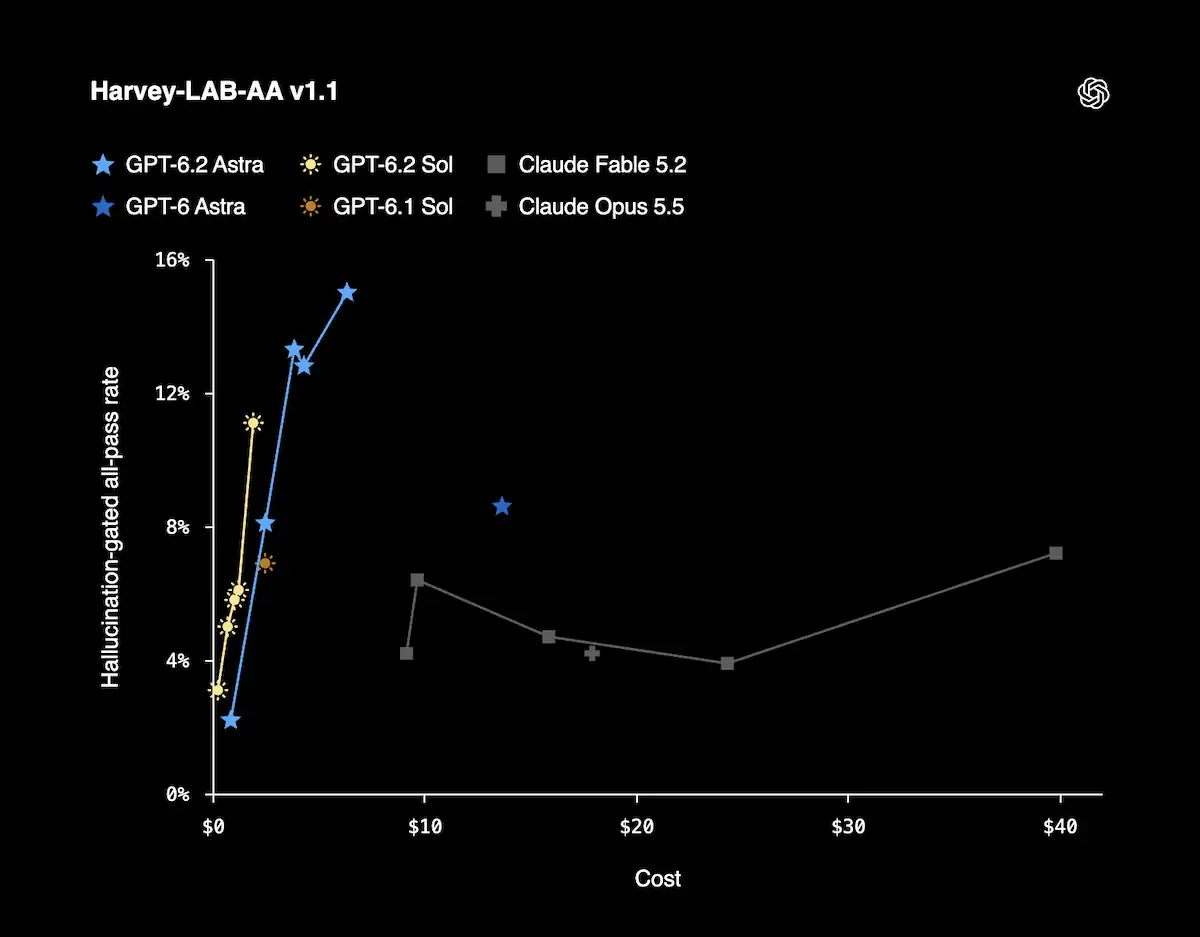
这代模型在「科学计算终端」和「法律尽职调查」这两个专业门槛较高的领域,展现出了明显跃升!(ps:前天发布的Qwen4也是如此,估计大家都开始尝试让AI干更多领域的活了, 点我顺便看看Qwen4发布测评 )
-
在科学界(Terminal-Bench-Science):Astra 的得分处于领先梯队。这代表它在纯命令行(CLI)环境下,能更精准地调用生信分析、物理模拟等硬核科学工具,并能处理动辄几十万行的运行日志。
-
在法学界(Harvey-LAB):这是最能体现「商业交付级」的测试。代表 Astra 的蓝线(接近 16%)直接将 Claude Fable 5.2(不到 8%)的通过率翻了接近一倍,且 Token 消耗更低。在真正的并购尽调、合同审查中,最致命的是「编造不存在的法条」(幻觉)。Astra 更低的事实幻觉率和更强的长文本一致性,意味着它在 LegalTech 和金融投研自动化领域,已经具备直接投入商用的潜力。
3. 物理世界与 3D 推理的进化:突破了“二维文本”的局限
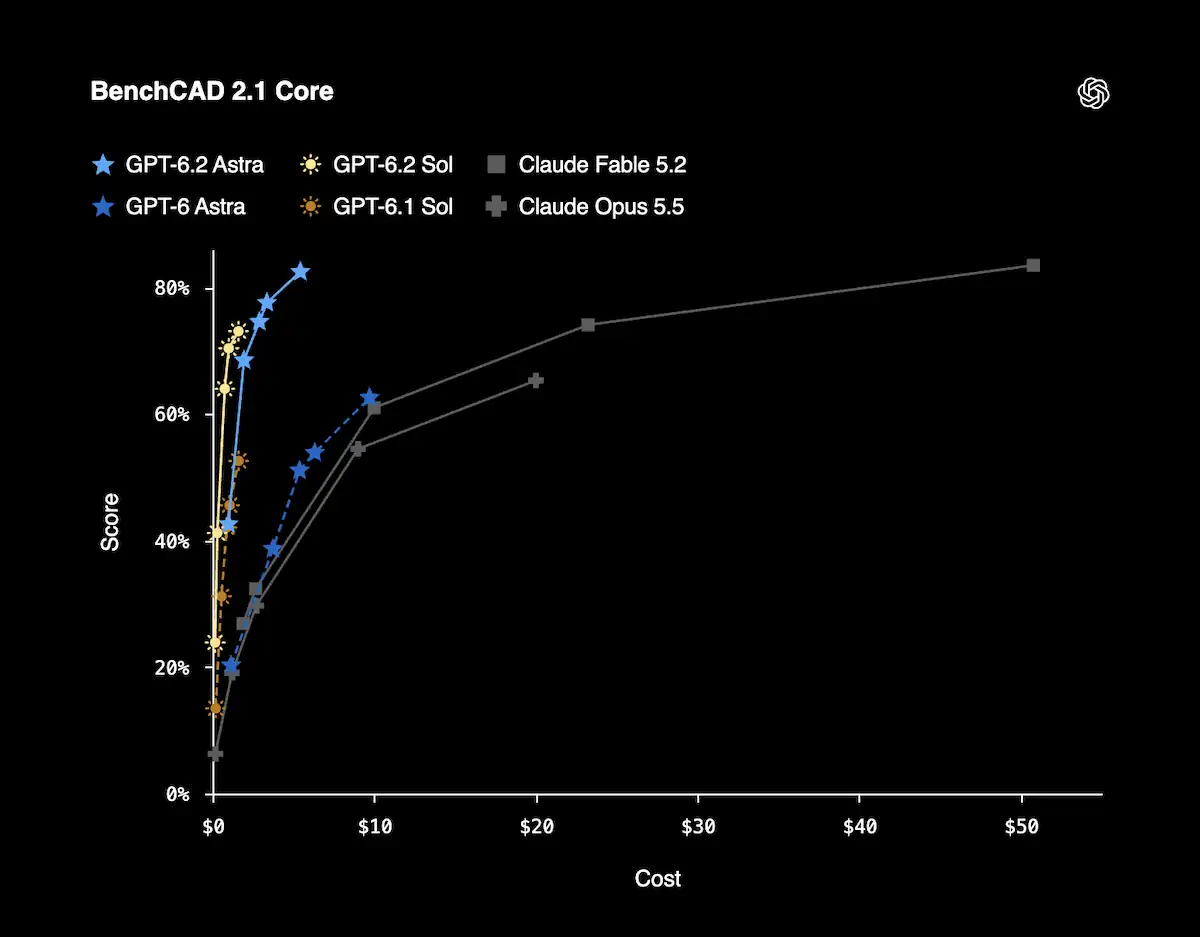
看最上方的这条蓝线(Astra),在三维 CAD 建模和工程重建测试中,它拿到了 80% 以上的通过率,直接把其他模型甩开了一个身位。
传统大模型本质上是「二维文本生物」,空间想象力和物理常识偏弱。BenchCAD 测试要求模型理解三维拓扑结构,甚至物理受力形变。Astra 能在此霸榜,说明它在训练底层不仅喂了代码,还深度融合了物理引擎和几何空间逻辑。这对未来的具身智能(机器人控制)、自动驾驶仿真,以及工业 BIM(建筑信息模型)生成,都是实打实的能力跃升。
总结一下吧: 官方数据证明了 Astra 是一台真正的「工程印钞机」。它用更强的推理效率和长程专注力,把钱花在了刀刃上。但纸面数据再华丽,也掩盖不了它在真实交互场景下的偏科。接下来马上进入我辛苦搞出的实机测试环节~
三、 实机重度实测:后端明显更强,前端、速度、表达仍有短板
官方数据再好看,真实业务里的手感才是王道。以下是基于我实机跑测得出的核心优缺点。
实测亮点 1:地表最强的后端逻辑
在让 Astra 和 Sol 生成极其复杂的后端算法(如分布式锁、高并发队列、复杂状态机)时,它们展现出了很高的逻辑严密性。
可以说,在纯后端逻辑和长上下文一致性上,6.2 系列(尤其是 Astra)已经明显强于 Claude Fable 5.2。 它能更准确地理解复杂业务诉求,并在内部完成多重依赖关系的推演,一次成型的概率明显更高。
实测亮点 2:硬核工程数据展示-很强的三维能力
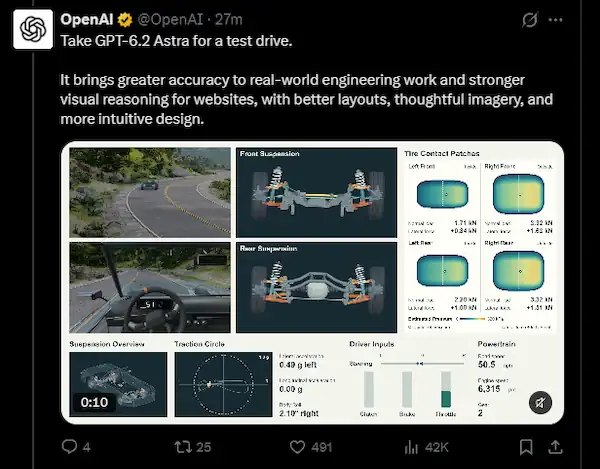
看官方这条推特,这是 Astra 在生成 3D 交互网页时的实际渲染画面。注意右侧的「轮胎接触面压力分布」「悬挂行程(Front/Rear Suspension)」以及「驾驶员输入(Driver Input)」。
这是相当硬核的工程级能力。它不仅写前端代码,还在实时计算真实的物理引擎参数。真的是震惊瘫坐了,说明 Astra 在处理复杂的、带物理法则的交互场景时,已经脱离了「只会调包」的范畴。在我实测中,发现6.2系列在绘制三维鹈鹕骑车时效果明显比上代好。
真实痛点 1:前端能力依然被Claude吊打
虽然官方放出了上面那段惊艳的 3D 物理引擎代码,但我实测让它写常规的 React 和 Vue 组件时,体验依然一般。
和前代相比,它的前端 UI 结构确实有一定改善(不像以前那样经常错位),但面对复杂的组件嵌套、状态管理(如 Redux / Pinia 的跨组件联动)时,它写出来的代码依然比 Claude Fable 5.2 逊色一个档次。Claude 更像是懂设计的资深前端,而 6.2 更像是个勉强能把图画出来的后端老哥。
真实痛点 2:输出速度依旧非常糟糕
这是最让人抓狂的地方。实测下来,它的输出速度大概只有 40 Tokens/秒 (有些网友甚至在astra6.2上得到了25t/s的速度)。
你要知道,现在很多开源模型已经跑到了 100+ Tokens/秒,特别是 Deepseek-v4.1-flash ,居然可以跑到 250+ Tokens/秒!在开启高强度的推理模式(High Effort)时,等它吐一段完整的后端代码,你需要盯着屏幕干瞪眼好几分钟。它虽然学会了“少说废话”,但它的“思考时间”长得令人发指。想象一下工作的时候,项目马上要交了,可是它却还不紧不慢的显示一个 Thinking + Worked for 114514小时,甚至有时候还慢吞吞地压缩个上下文,只能陪着他熬夜咯,哎......
真实痛点 3:顽固的“防御性编程”
如果你是个追求代码极简的开发者,你一定会被它烦死。你只让它写一个加法函数,它非要给你套上各种非空判断、类型校验、异常捕获。特别是,我经常遇到项目开发一会,就产生大量的SHA256和什么全量测试、烟测、回归......这种保守的代码生成风格,后续清理起来确实比较恶心。而且语言风格依旧是火星文(好像有所改善,但微乎其微),比如:“我不能准确地认定我的语言风格已经有所改善,因此,我不能说...”
四、开发者选型建议:怎么用更合适?
结合它的后端明显更强、常规前端偏弱、速度偏慢的特点,我给出以下选型建议:
- 主力跑后端和重逻辑:优先选
gpt-6.2-astra。它能帮你省去大量排查底层逻辑 Bug 的时间,虽然稍微慢,但很强很稳,真的不烧心~ - 日常写前端、改样式:直接切回 Claude Fable 或者 Opus。GPT审美还是有所欠缺啊。
- 高性价比平替:用
gpt-6.2-sol。FrontierCode 测试只差 0.5 分,成本只有 1/5。日常写个脚本、做个数据清洗,Sol 完全够用,注意速度输出速度是和 Astra 差不多的。
极客 FAQ:你关心的几个实操问题
Q1:Astra 真的比 Claude Fable 5.2 在 Agent 上更强吗?
A:总体上是的。如果你做的是纯后端逻辑推演、复杂多步依赖(比如让它自己顺着线索查 Bug),或者长上下文一致性要求极高的工作,Astra 确实比 Claude 更强,而且差距不小。但如果你要写常规前端 UI,或者需要极快的响应速度,别犹豫,切回 Claude。Astra 在前端和速度上确实不占优势。
Q2:缓存机制怎么用才能把成本降到最低?
A:他自己给了我一句很有意思的话:「铁打的营盘流水的兵」。把那些绝对不变的内容(比如几百页的行业文档、整个项目的代码框架、系统设定),永远固定放在 Prompt 的最前面。后续追问时,只在最后面加新问题。只要触发缓存,Astra 只要 $0.40,Sol 只要 $0.10,这才是真正省钱的地方。
Q3:官方演示的那个带物理参数的 3D 网页,到底是怎么实现的?
A:核心在于模型现在具备了更强的「工程物理参数推理」能力。你可以尝试用 Three.js 配合复杂的物理反馈提示词让它手写。过程确实比较煎熬(因为它慢),可能要等好几分钟。但一旦跑通,出来的代码质量很高,连悬挂行程、轮胎接触面压力分布都能给你算出来。建议放在后台异步跑,别在终端里干等。
写在最后:偏科不可怕,选错场景才尴尬
总的来说,这次 GPT-6.2 的更新,是一次典型的「偏科生」进化。
它把主要技能点砸在了重型推理和长程 Agent 上,牺牲了常规前端制作与设计能力,牺牲了创造和说人话的能力,也牺牲了极客最在意的响应速度。所以,选对场景,它是神器;选错场景,它真的会把你逼疯。
好消息!在官方发布的1小时内,AIHub8已全面上线GPT-6.2系列!无需折腾,后台直接生成令牌,将Model填为
gpt-6.2-sol或gpt-6.2-astra,即刻体验满血后端战力!
折腾了0.5宿,这次首发实测就先到这。如果这篇文帮你避开了几个暗坑,或者帮你省下了几个$40的输出费,转发一下或者支持一下我们站点就行,非常感谢喵。有新的奇葩发现可以随时群里联系我。明早再见,有变动会持续更新这篇文章!